NumPy (Numerical Python) ist eine mächtige Bibliothek für numerische Berechnungen im technisch-wissenschaftlichen Umfeld und bildet die Basis für viele weitere Pakete des Python-Ökosystems. Als wesentliche Erweiterungen von NumPy gegenüber Basis-Python können genannt werden:
leistungsfähiger Array-Datentyp für ein- bzw. mehrdimensionale Datenobjekte
leistungsfähige Algorithmen für mehrdimensionale Arrayobjekte
umfangreiche Sammlung mathematischer Funktionen
Wir werden NumPy schrittweise kennenlernen und über das gesamte Modul hinweg intensiv einsetzen, wobei nach und nach weitere Bibliotheken dazustossen.
🎯 Lernziele
Du kannst Gemeinsamkeiten & Unterschiede zwischen NumPy-Arrays und Python-Listen erläutern.
Du kannst 1D- bzw. 2D-Arrays erzeugen und damit Berechnungen durchführen.
Du kannst Arrays indizieren/slicen.
Du kennst wichtige NumPy-Funktionen zum Erstellen von Arrays, zum Einlesen von Arrays aus Textdateien sowie die wichtigsten Array-Attribute und Array-Methoden.
📋 Blockinhalt
Für die Einführung in NumPy bzw. die selbstständige Einarbeitung stehen die folgenden Notebooks bereit:
Einführung/Theorie/Cheatsheet (vorliegendes Notebook)
Beispielaufgabe im Unterricht Unterrichtsbeispiel
Übungsaufgaben Übungen
🛠 Voraussetzungen
Die Python-Grundlagen sowie der Umgang mit JupyterLab bzw. PyCharm werden vorausgesetzt und müssen gegebenenfalls selbstständig aufgefrischt werden. Speziell erwähnt seien:
Datentypen, v. a. numerische Datentypen und Listen (Erstellung, Indizierung etc.)
Kontrollstrukturen (Schleifen, Verzweigungen, Funktionen)
OOP: Zugriff auf Attribute & Methoden
Arbeiten mit JupyterLab (Unterschiede zu einer Entwicklungsumgebung wie PyCharm etc.)
Debugging / Verwenden der Hilfe bzw. der Dokumentation
Speziell die Indizierung soll hier kurz repetiert werden. Die Indizierung einer einfachen Liste erfolgt bekanntlich mit [], wobei das erste Element mit dem Index 0 angesprochen wird.
liste = [5, 3, 2, 8, 1]
liste[0]  # erstes Element
liste[-1]  # letztes Element
liste[1:4]  # Liste mit zweitem, drittem und viertem Element (Slicing)
Bei verschachtelten Listen kommt pro Verschachtelungsebene ein Index hinzu, wobei dann mit mehreren Klammern [][] etc. indiziert wird.
liste = [[1, 2], ['a', 'b', 'c']]
liste[0]  # erstes Element der obersten Verschachtelungsebene (= [1, 2])
liste[1]  # zweites Element der obersten Verschachtelungsebene (= ['a', 'b', 'c'])
liste[0][1]  # zweites Element der ersten Unterliste (= 2)
☝🏼 Ebenfalls zu erwähnen ist, dass in den Jupyter-Notebooks häufig auf die print()-Funktion verzichtet wird, um eine Grösse am Bildschirm auszugeben. Dies ist möglich, weil in JupyterLab der Rückgabewert der letzten Anweisung einer Code-Zelle automatisch ausgegeben wird. Die Formatierung der Ausgabe kann von derjenigen der print()-Funktion leicht abweichen.
print('Hello World!')  # print()-Funktion zur Ausgabe

'Hello World!'  # Rückgabewert der letzten Anweisung wird automatisch ausgegeben
Hello World!
'Hello World!'Im mathematischen Bereich wird vorausgesetzt, dass du die folgenden Themengebiete beherrschst. Repetiere diese selbstständig, falls sie nicht mehr präsent sind.
Betrag (Absolutwert) einer Zahl:
Winkelfunktionen (, etc.) sowie deren Umkehrfunktionen (, etc.)
Umrechnung von ° (Grad) in rad (Radiant) und umgekehrt: 360°
Satz des Pythagoras:
Wurzelziehen bzw. Quadrieren: bzw.
Exponential- bzw. Logarithmusfunktion bzw.
logarithmische Darstellung in Diagrammen
1. Motivation
Die grundlegenden Python-Datentypen (list, tuple, dict) eignen sich nicht für mathematische Berechnungen. NumPy bringt mit dem NumPy-Array (ndarray) einen sehr nützlichen Datentyp mit sich, der effiziente Berechnungen (auch grosser Datenmengen) ermöglicht.
☝🏼 Überlege dir übungshalber kurz, wie du alle Elemente einer Liste my_list = [1, 2, 3] z. B. quadrieren würdest. Wäre z. B. my_list**2 möglich? Probier es aus.
Im vorliegenden Notebook werden wir die wichtigsten Features von NumPy durchgehen, doch es ist nicht möglich (und auch nicht sinnvoll) alles bis ins letzte Detail anzuschauen. An dieser Stelle soll daher auch auf das Cheatsheet hingewiesen werden, welches das Wichtigste kompakt zusammenfasst. Für weiterführende Informationen können folgende Ressourcen erwähnt werden:
1.1 Import
NumPy (Paketname numpy) wird üblicherweise mit dem Alias np importiert. Du solltest NumPy bereits installiert haben, ansonsten kannst du es mit pip install numpy via Terminal (→ JupyterLab Launcher → Terminal) oder mit ! pip install numpy direkt im Notebook installieren.
import numpy as np2. Array (ndarray)
Der ndarray (nachfolgend einfach Array genannt) ist die zentrale Datenstruktur der NumPy-Bibliothek und kann ein-, zwei- oder auch höherdimensional sein. Da der Array viele Ähnlichkeiten mit der Liste aufweist, können wir bzgl. Erstellung und Indizierung auf das vorhandene Wissen aufbauen.
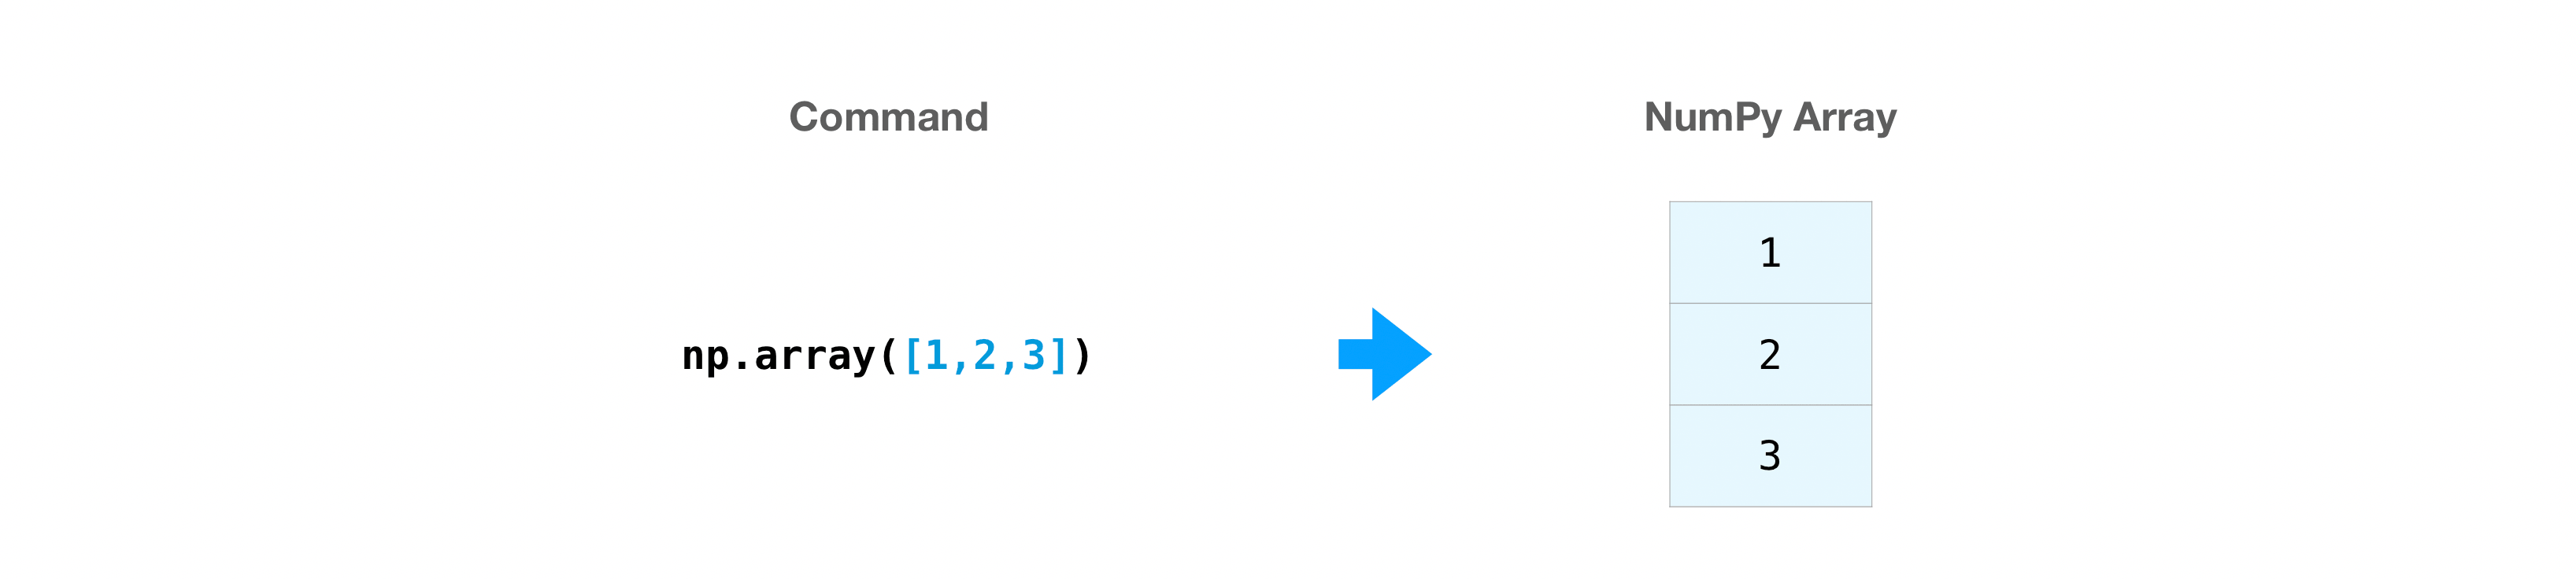
Abb.: Erstellen eines 1D-Arrays
☝🏼 Einen eindimensionalen Array (1D-Array) sollte man sich ohne Orientierung (also nicht als Zeile oder Spalte) vorstellen, sondern einfach als Anordnung von Elementen (wie eine Liste).
a = np.array([-1.23, 0, 2.5])  # manuelle Erstellung eines Arrays
print(a)
type(a)
[-1.23 0. 2.5 ]
numpy.ndarray☝🏼 Es fällt auf, dass die Ausgabe eines Arrays am Bildschirm (siehe oben bei print(a)) gleich aussieht wie bei einer Liste. Arrays und Listen haben viele Ähnlichkeiten, doch es ist wichtig, dass du dir immer im Klaren über den Datentyp bist. Im Zweifelsfall hilft die bekannte Funktion type(), um den Datentyp zu bestimmen.
2.1 Erstellung
Für die Erstellung von 1D-Arrays wird meistens eine der folgenden Funktionen verwendet:
np.array()- für die manuelle Erzeugung (oder Konversion von einem anderen Datentyp)np.arange()- analog zur Funktionrange(), aber nicht auf Ganzzahlen beschränktnp.linspace()- wienp.arange(), aber mit Sampleanzahl anstelle der Schrittweitenp.logspace()- wienp.linspace(), aber mit logarithmischer Teilung
a = np.array([-1, 0, 1, 2])  # manuell, ähnlich zur Erstellung einer Liste
print(a)
a = np.arange(0, 1, step=0.2) # (Startwert, Endwert (nicht inkl.), Schrittweite)
print(a)
a = np.linspace(0, 5, num=9)  # (Startwert, Endwert (inkl.), Sampleanzahl)
print(a)
a = np.linspace(0, 5, num=9, endpoint=False)  # wie oben, aber diesmal Endwert nicht inkl.
print(a)
a = np.logspace(-2, 3, num=6, base=10.0)  # logarithmische Teilung
print(a)
[-1 0 1 2]
[0. 0.2 0.4 0.6 0.8]
[0. 0.625 1.25 1.875 2.5 3.125 3.75 4.375 5. ]
[0. 0.55555556 1.11111111 1.66666667 2.22222222 2.77777778
3.33333333 3.88888889 4.44444444]
[1.e-02 1.e-01 1.e+00 1.e+01 1.e+02 1.e+03]
Höherdimensionale Arrays können ebenfalls ähnlich wie Listen mit np.array() erstellt werden.
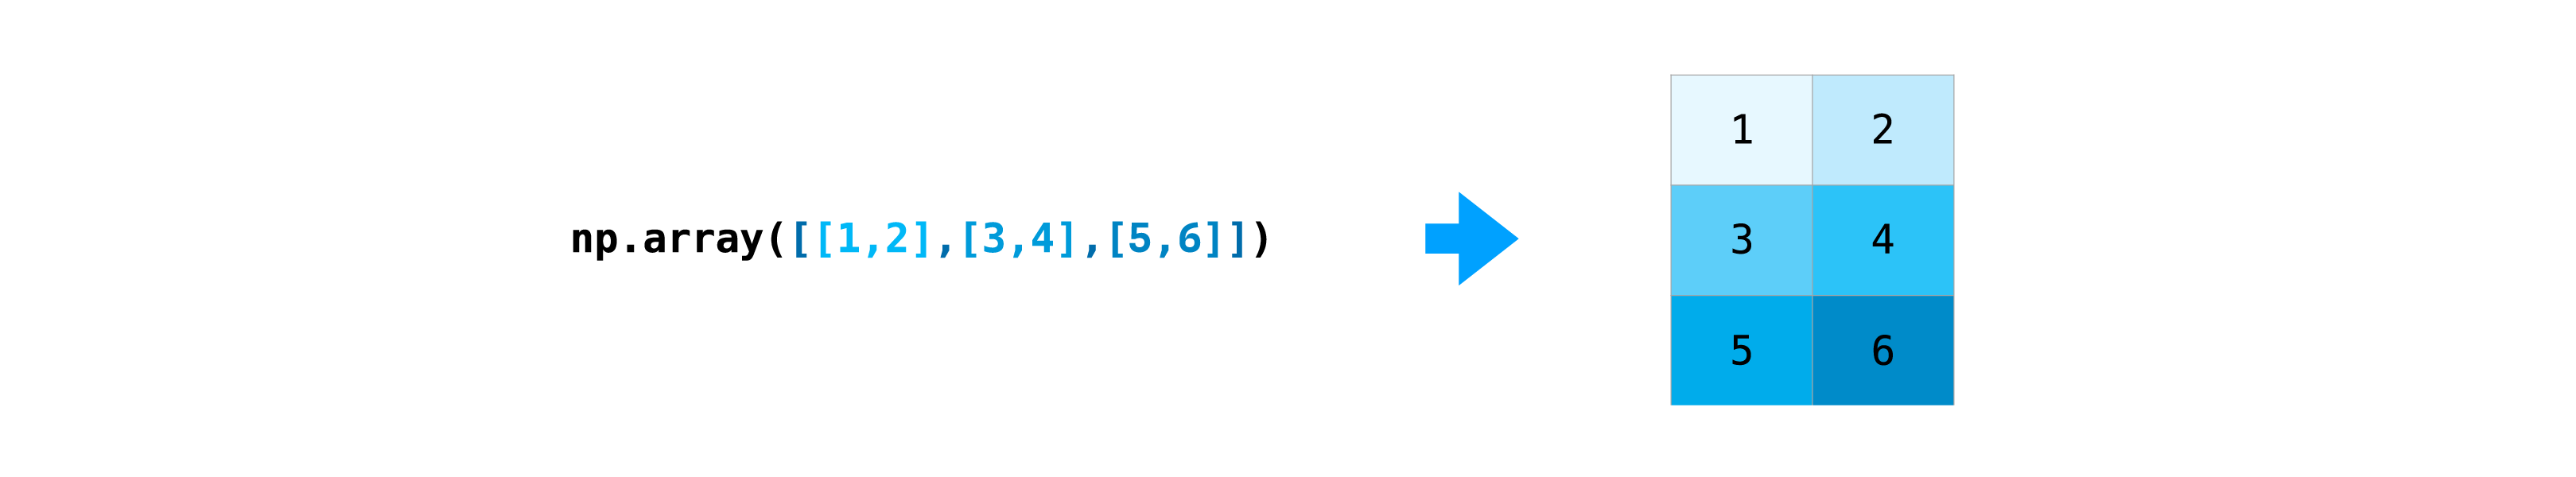
Abb.: Erstellen eines 2D-Arrays
☝🏼 Dimension bedeutet im Zusammenhang mit Arrays, wie viele Achsen (Richtungen) der Array aufweist. Ein zweidimensionaler Array (2D-Array) hat z. B. zwei Achsen, d. h. eine bestimmte Anzahl Zeilen und eine bestimmte Anzahl Spalten. Ein Array ist immer rechteckig/quadratisch, d. h. die Anzahl der Spalten ist in jeder Zeile gleich (und umgekehrt).
Für das Erstellen von Arrays mit Nullen bzw. Einsen oder Zufallszahlen gibt es ebenfalls nützliche Funktionen. Daneben gibt es eine Reihe von Funktionen, welche man im Zusammenhang mit der linearen Algebra (Vektor- bzw. Matrizenrechnung) häufig benötigt.
np.zeros()bzw.np.ones()- für die Erstellung eines Arrays mit 0 bzw. 1np.random.random()bzw.np.random.uniform()für gleichverteilte Zufallszahlennp.random.uniform()bzw.np.random.normal()für gleichverteilte bzw. normalverteilte Zufallszahlennp.eye()bzw.np.diag()- Einheitsmatrix (Diagonalelemente = 1, Rest = 0) bzw. Diagonalmatrix
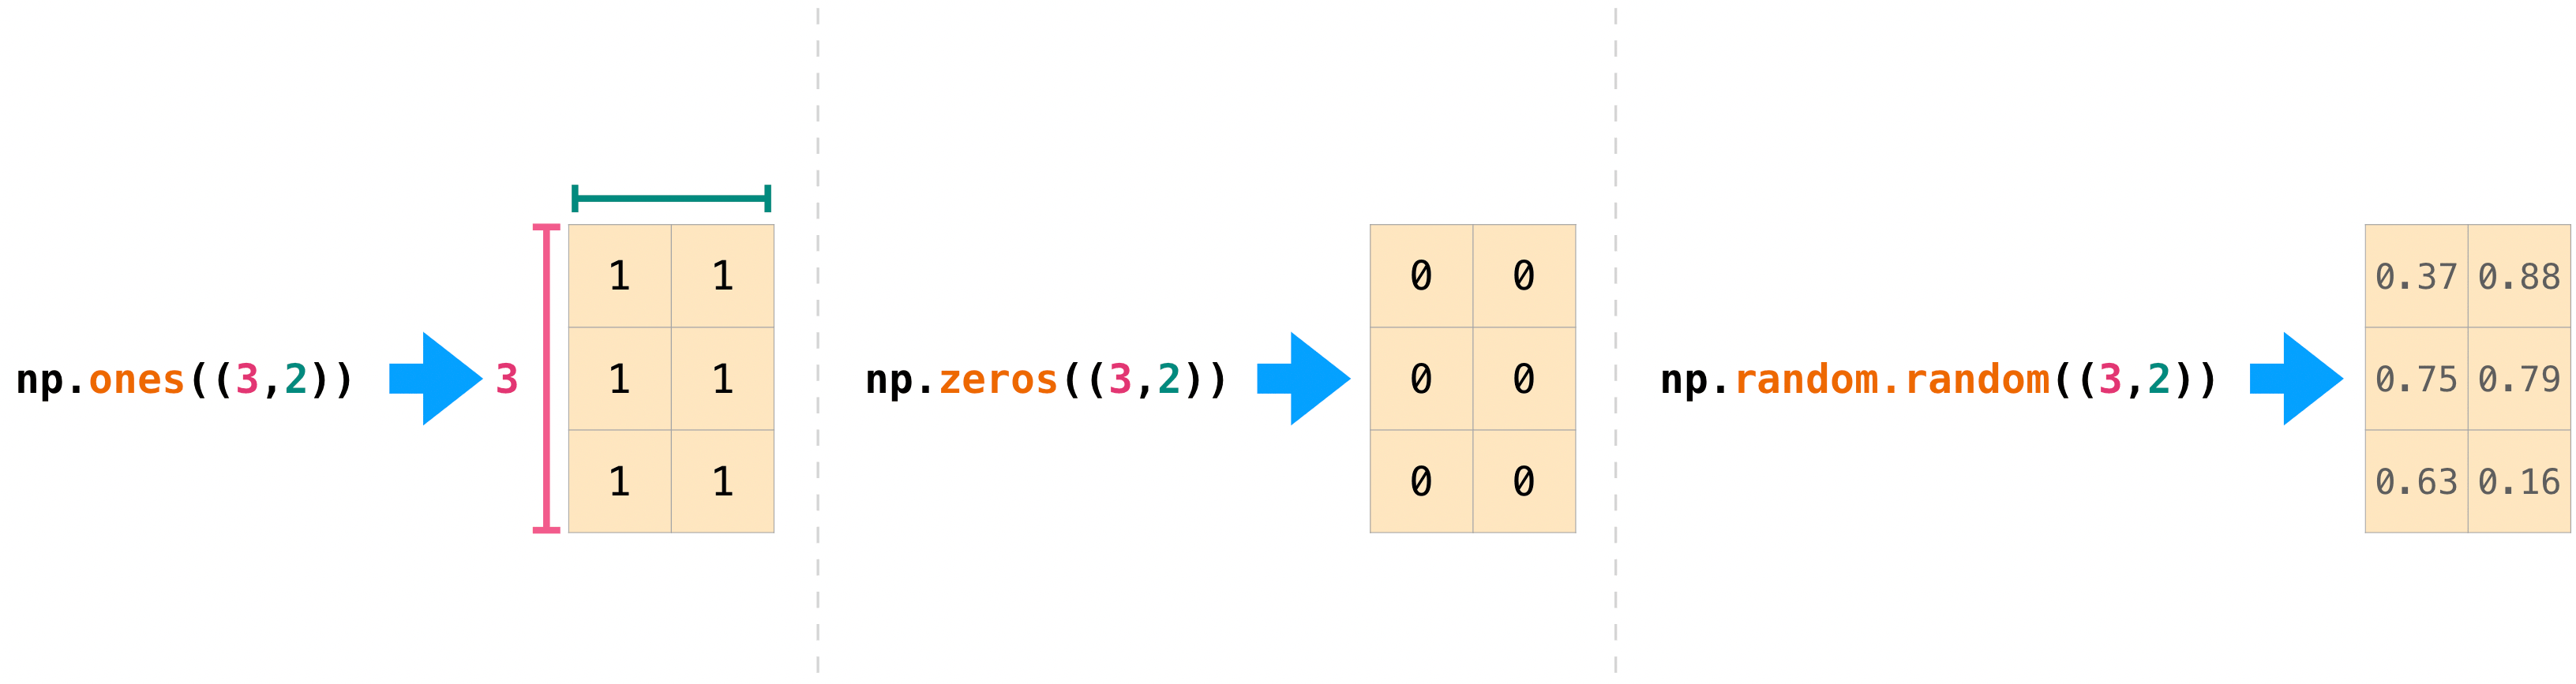
Abb.: Nützliche Funktionen für die Erstellung typischer Arrays
a = np.zeros(10)  # 1D-Array mit 10 Elementen (alle Elemente = 0)
print(a)
a = np.ones(shape=(3,5))  # 2D-Array mit 3 Zeilen und 5 Spalten (alle Elemente = 1)
print(a)
a = np.random.uniform(size=(3,2))  # 2D-Array mit 3 Zeilen und 2 Spalten (gleichverteilte Zufallszahlen 0-1)
print(a)
[0. 0. 0. 0. 0. 0. 0. 0. 0. 0.]
[[1. 1. 1. 1. 1.]
[1. 1. 1. 1. 1.]
[1. 1. 1. 1. 1.]]
[[0.05398509 0.59687343]
[0.49068422 0.43250767]
[0.1248439 0.32474688]]
2.1.1 Import/Export von Textdateien
Zweidimensionale Arrays werden häufig im Zusammenhang mit eingelesenen Daten (Textfiles, Bilder, etc.) verwendet und eher selten manuell erstellt. Für das Arbeiten mit Textdateien (.txt, .csv) sind die folgenden beiden Funktionen zu erwähnen:
np.loadtxt()- Einlesen einer Textdateinp.savetxt()- Abspeichern in eine Textdatei
Wie immer beim Einlesen von Textdateien ist darauf zu achten, ob Headerzeilen vorhanden sind, die ignoriert werden müssen und welches Zeichen als Trennzeichen verwendet wird (bei mehreren Spalten). Die obigen Funktionen enthalten dafür entsprechende Parameter (skiprows bzw. delimiter).
☝🏼 Bei den Python-Grundlagen haben wir die generischen Funktionen zum Lesen/Schreiben von Textdateien kennengelernt (open(), read()/readlines() bzw. write()/writelines() und close()). Die obigen NumPy-Funktionen übernehmen diese “Low-Level-Tätigkeiten” und erleichtern somit das Lesen/Schreiben von numerischen Daten aus/in Textdateien enorm.
data = np.loadtxt('data/test.txt')  # Textfile mit 10 Zeilen bzw. 4 Spalten importieren
print(data)
[[4.62650899 4.74427106 4.10718883 5.74741935]
[3.93716262 4.44784082 3.99927829 7.58004246]
[5.44879718 7.63339694 5.40630074 3.79795342]
[4.73982477 4.94725306 5.26614751 5.82502817]
[4.05503805 6.60537579 4.61824488 4.41528259]
[4.81223345 5.50310081 3.34210142 5.68354476]
[6.214162 4.61120806 5.23661798 4.98292635]
[5.961609 4.12163329 4.64128046 4.17107427]
[5.91600386 4.94482552 4.91290316 3.37916316]
[5.38327685 5.54139824 5.38787453 4.85609505]]
2.2 Array-Attribute
Der NumPy-Array kommt mit vielen Attributen, welche nützlich sind, um z. B. Dimension, Grösse, Datentyp etc. abfragen zu können.
.ndim- Dimension des Arrays.shape- Form/Grösse, d.h. Anzahl Zeilen & Spalten etc..size- Gesamtanzahl Elemente.dtype- Element-Datentyp.realbzw..imag- Real- bzw. Imaginärteil bei komplexen Zahlen
☝🏼 Die Python-Funktion len() gibt bei Arrays jeweils die Länge der ersten Dimension (z. B. Anzahl Zeilen bei 2D-Array) zurück. Besonders bei höherdimensionalen Arrays bzw. wenn sich die Arraydimensionen verändern, wird deshalb besser mit .shape gearbeitet.
☝🏼 Im Gegensatz zu Listen kann ein Array nicht verschiedene Datentypen enthalten. Alle Elemente eines Arrays haben denselben Datentyp (int/float/complex).
print(a.ndim)  # Array-Dimension
print(a.shape)  # Array-Shape (Anzahl Zeilen/Spalten etc.)
print(a.size)  # Anzahl Elemente (gesamthaft)
print(a.dtype)  # Element-Datentyp
2
(3, 2)
6
float64
2.3 Array-Methoden
Neben den oben erwähnten Attributen bietet der NumPy-Array viele nützliche Operationen direkt als Methoden an, was eine elegante/übersichtliche Programmierung ermöglicht.
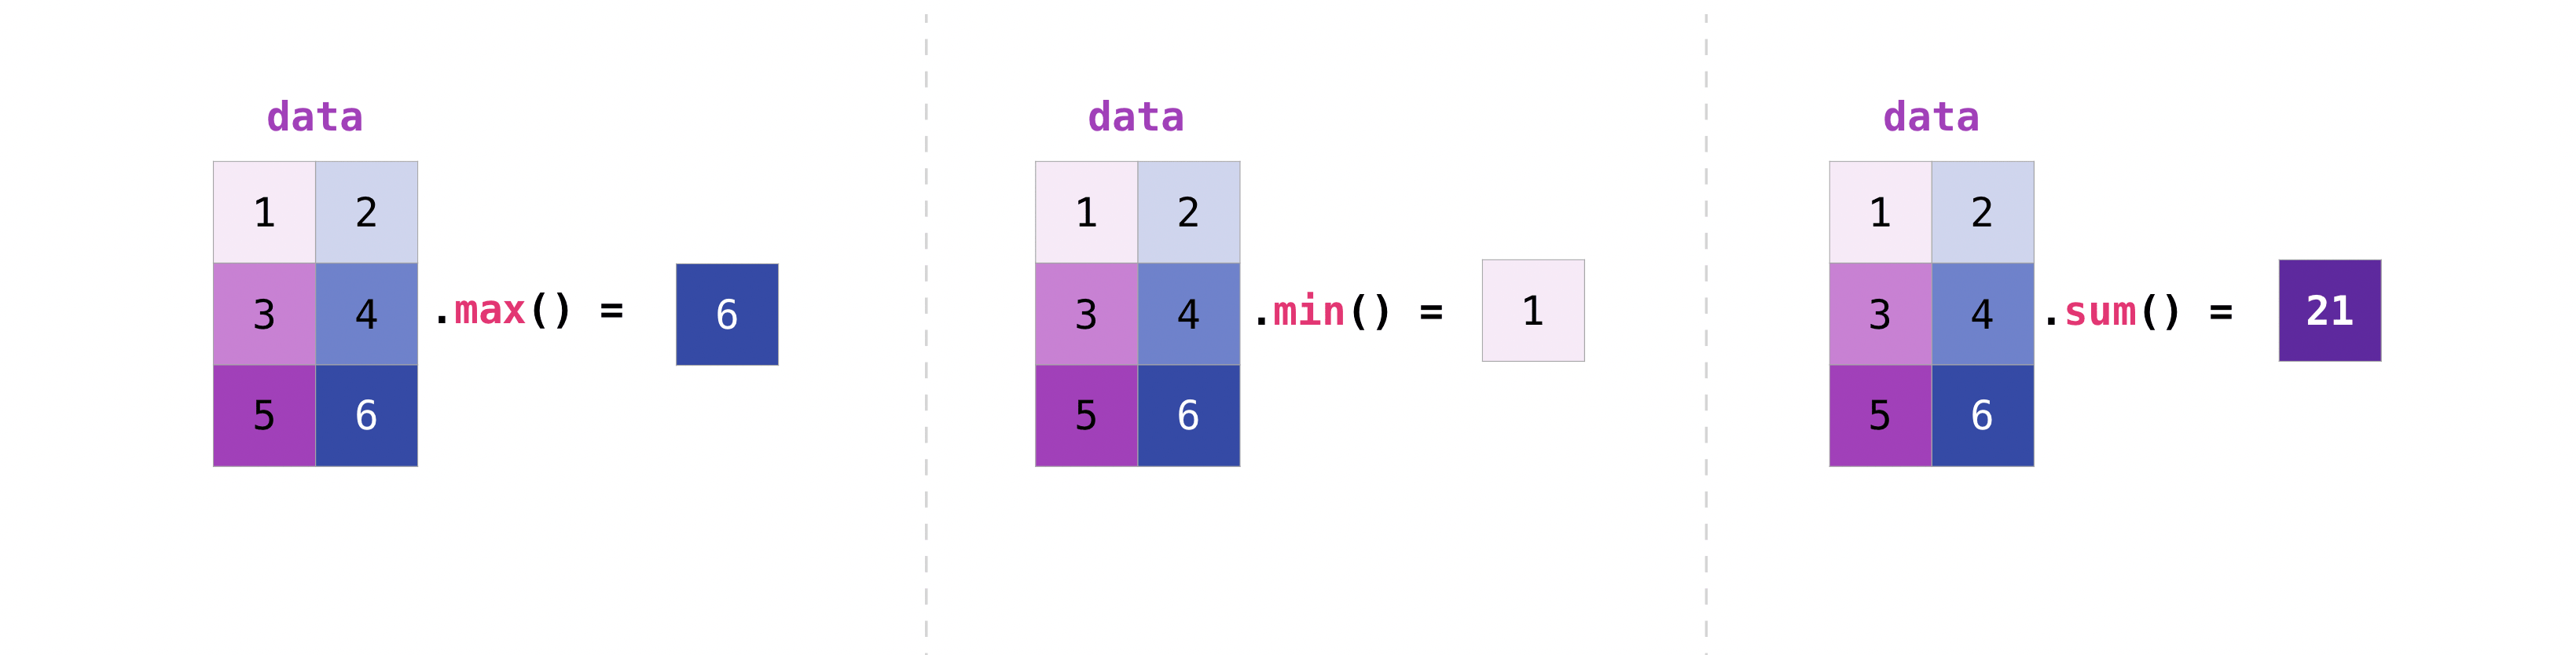
Abb.: Nützliche Array-Methoden
Nützliche Methoden:
.max()bzw..min()- Maximum bzw. Minimum des Arrays.argmax()bzw..argmin()- Index des Maximums bzw. Minimums.mean(),.std(),.var()- Mittelwert, Standardabweichung, Varianz.sum()bzw..cumsum()- Summe bzw. kumulierte Summe.prod()bzw..cumprod()- Produkt bzw. kumuliertes Produkt.round()- Runden.sort()- Sortierung.transpose()- Transponierung (vgl. Vektorrechnung)
Viele der obigen Methoden existieren auch als allg. Funktionen in NumPy. Das Maximum eines Arrays kann z. B. entweder via Methode a.max() oder via Funktion np.max(a) bestimmt werden.
☝🏼 Bei Funktionen wie z. B. .sum() oder .max(), bei denen die Anwendung auf einen höherdimensionalen Array nicht eindeutig ist, kann mit dem Parameter axis angegeben werden, ob die Operation zeilen- bzw. spaltenweise durchgeführt werden soll oder auf den gesamten Array angewendet werden soll.
axis = 0- pro Spalte (z. B. Spaltensummen)axis = 1- pro Zeile (z. B. Zeilensummen)axis = None- über alle Elemente (Default)
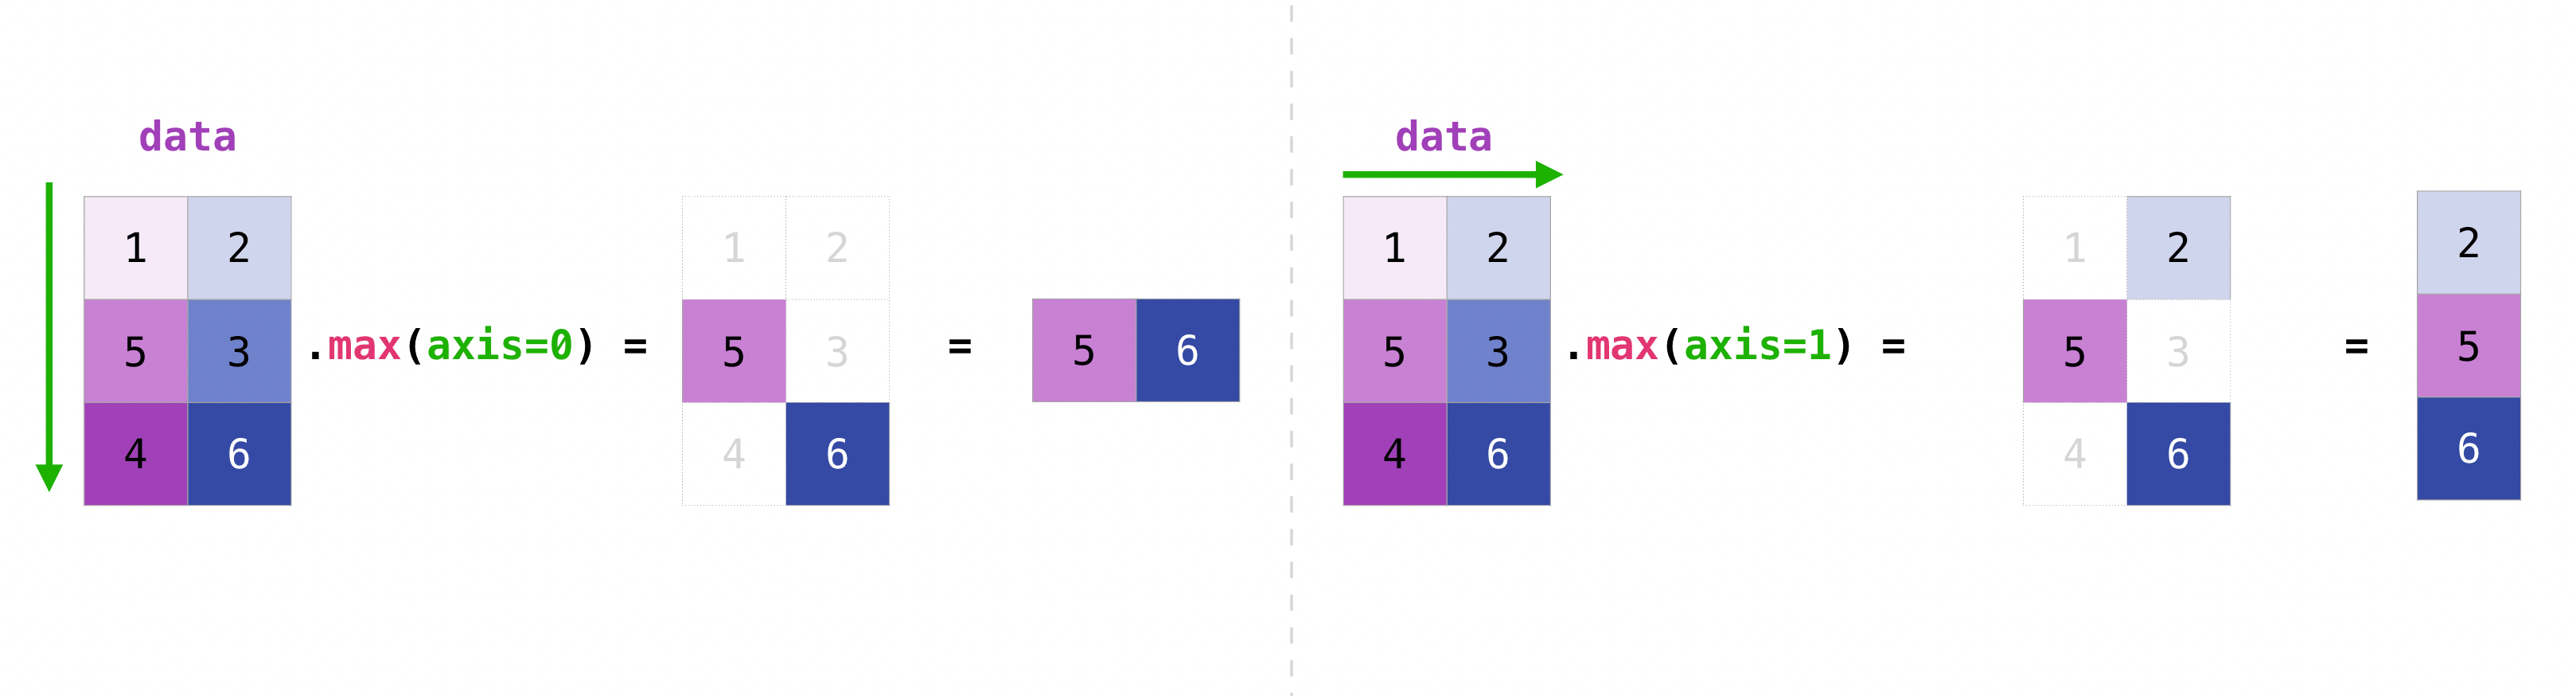
Abb.: Aggregationsfunktionen spalten- oder zeilenweise anwenden
print(a.mean())  # Mittelwert aller Elemente
print(a.sum())  # Summe aller Elemente
print(a.sum(axis=0))  # Spaltensummen
print(a.sum(axis=1))  # Zeilensummen
0.3372735310750065
2.023641186450039
[0.6695132 1.35412798]
[0.65085852 0.92319188 0.44959078]
3. Form/Gestalt eines Arrays
Sehr wichtig im Zusammenhang mit Arrays (besonders mit höherdimensionalen) ist, dass man sich immer im Klaren über die Dimension und die Form/Gestalt (shape) des Arrays ist, da das Debugging sonst mühsam werden kann. Dies ist v. a. in Bezug auf die Indizierung sehr wichtig. Wir werden primär mit 1D- und 2D-Arrays zu tun haben, es sind aber auch drei- und höherdimensionale Arrays möglich.
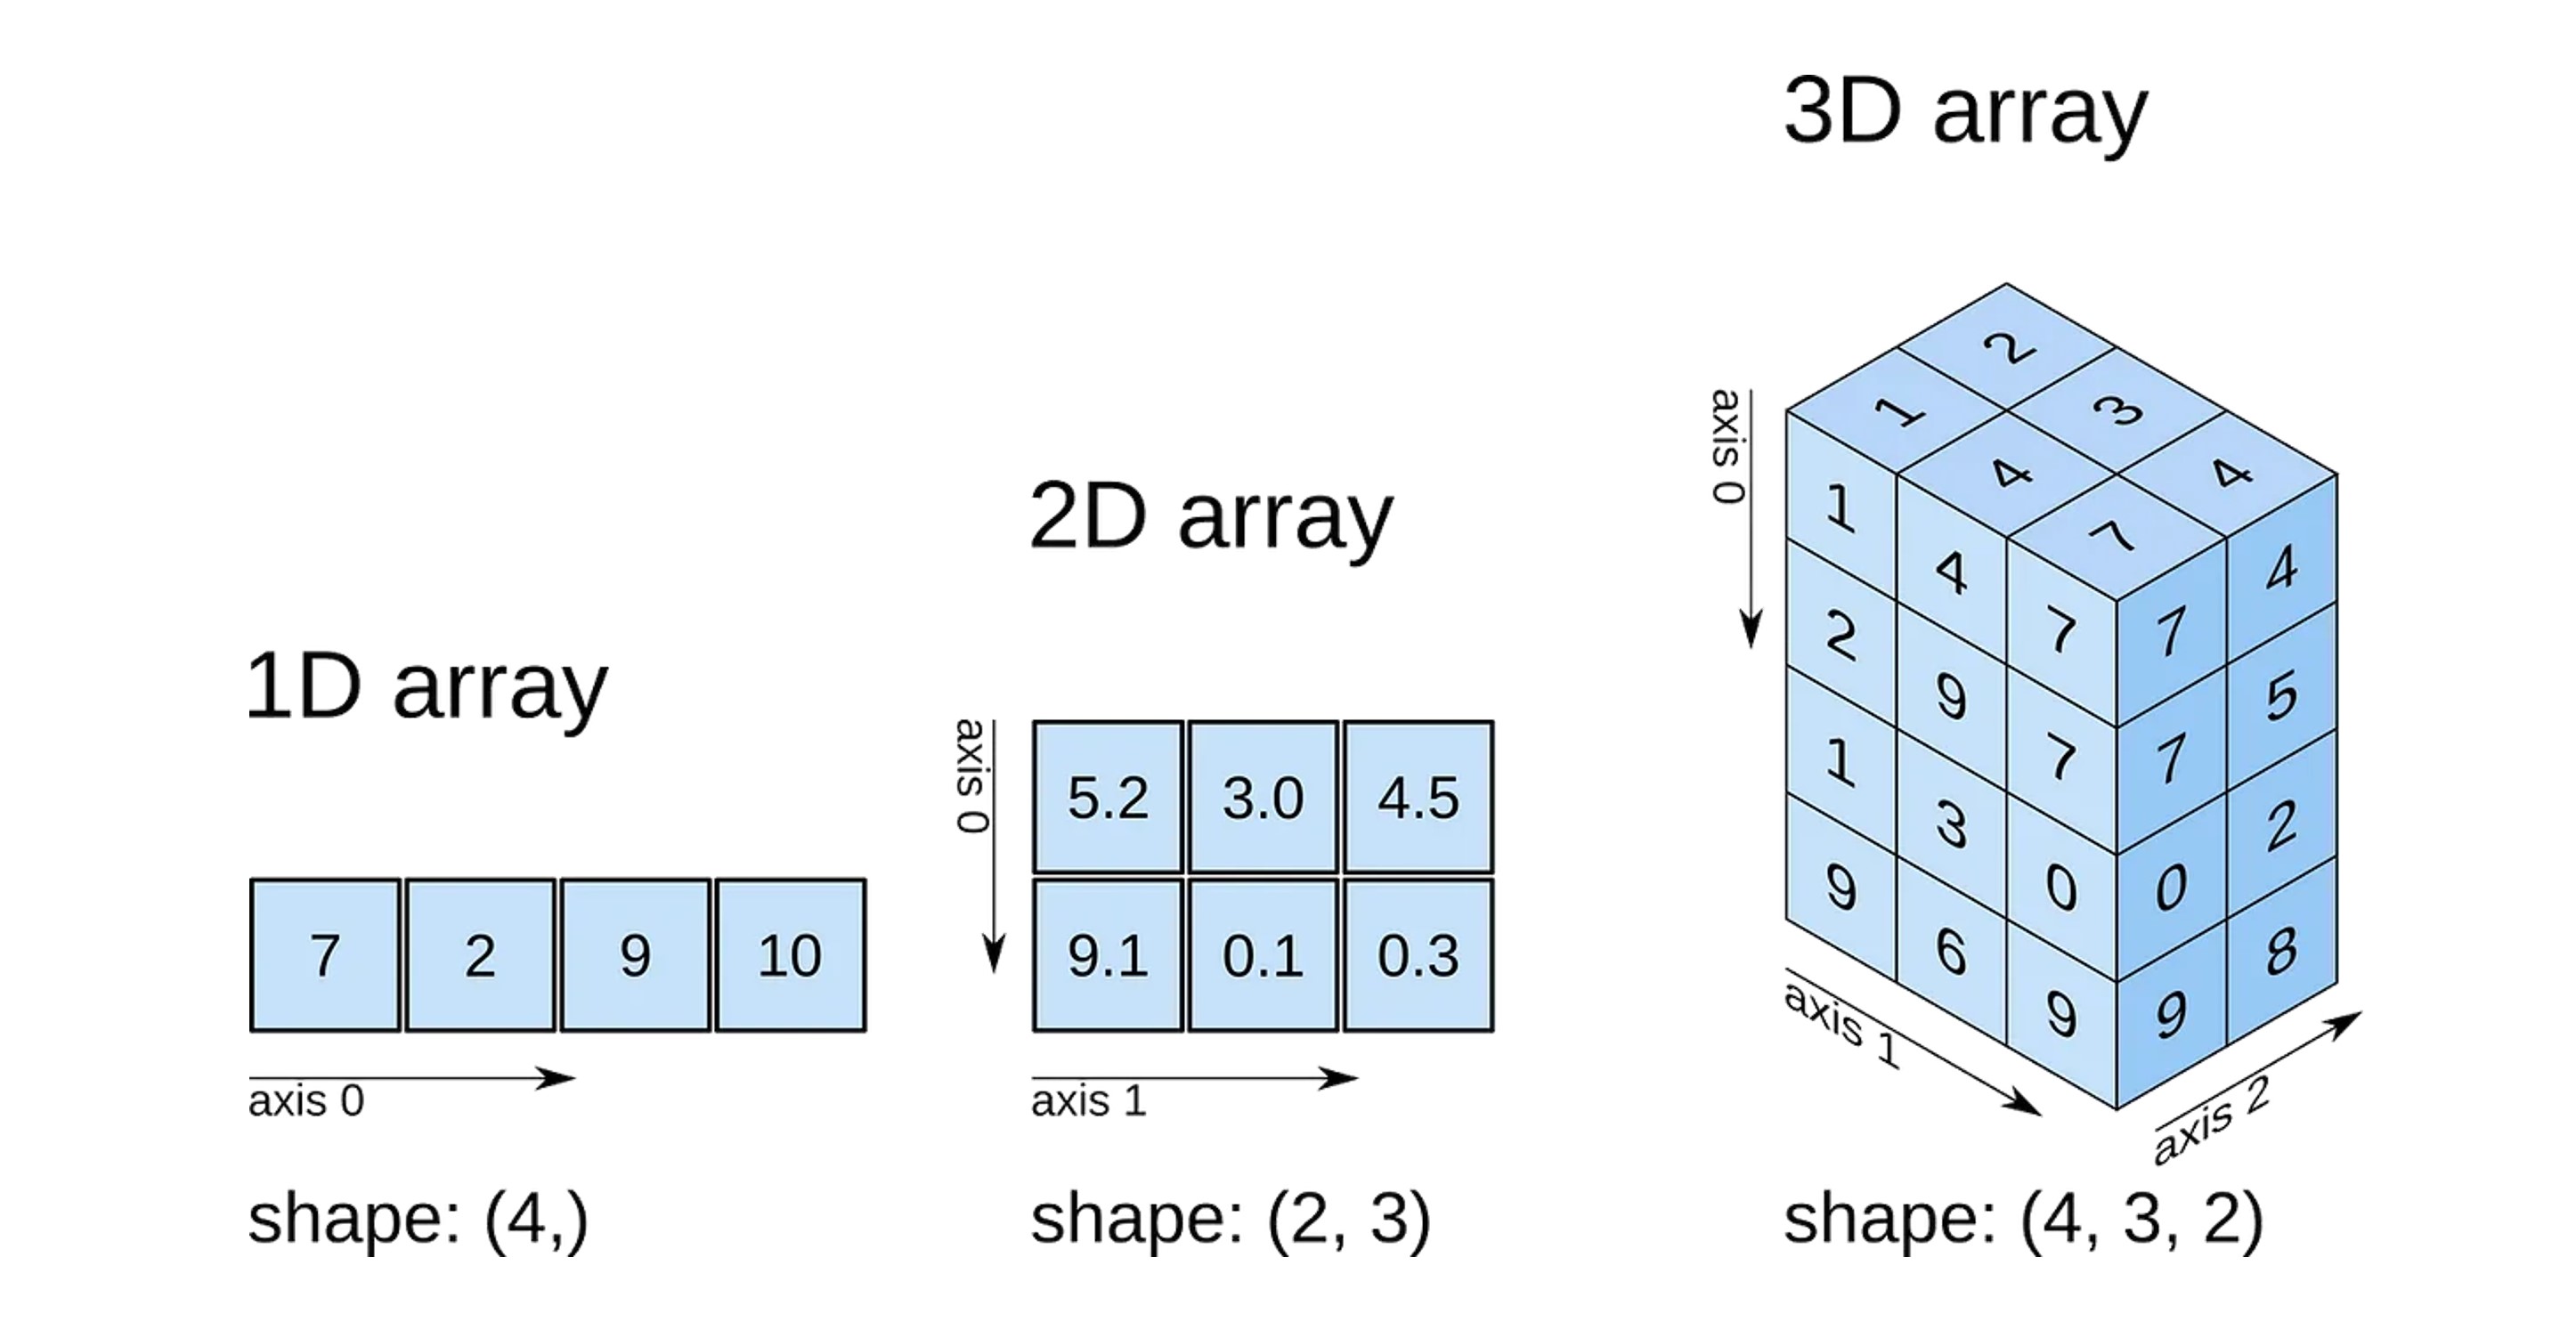
Abb.: Shape (Form) des Arrays
3.1 Formänderung
Die Array-Methode .reshape() ermöglicht es, die Dimension eines Arrays zu ändern, also z. B. einen 1D-Array mit 6 Elementen in einen 2D-Array mit z. B. 2 Zeilen & 3 Spalten zu verwandeln.
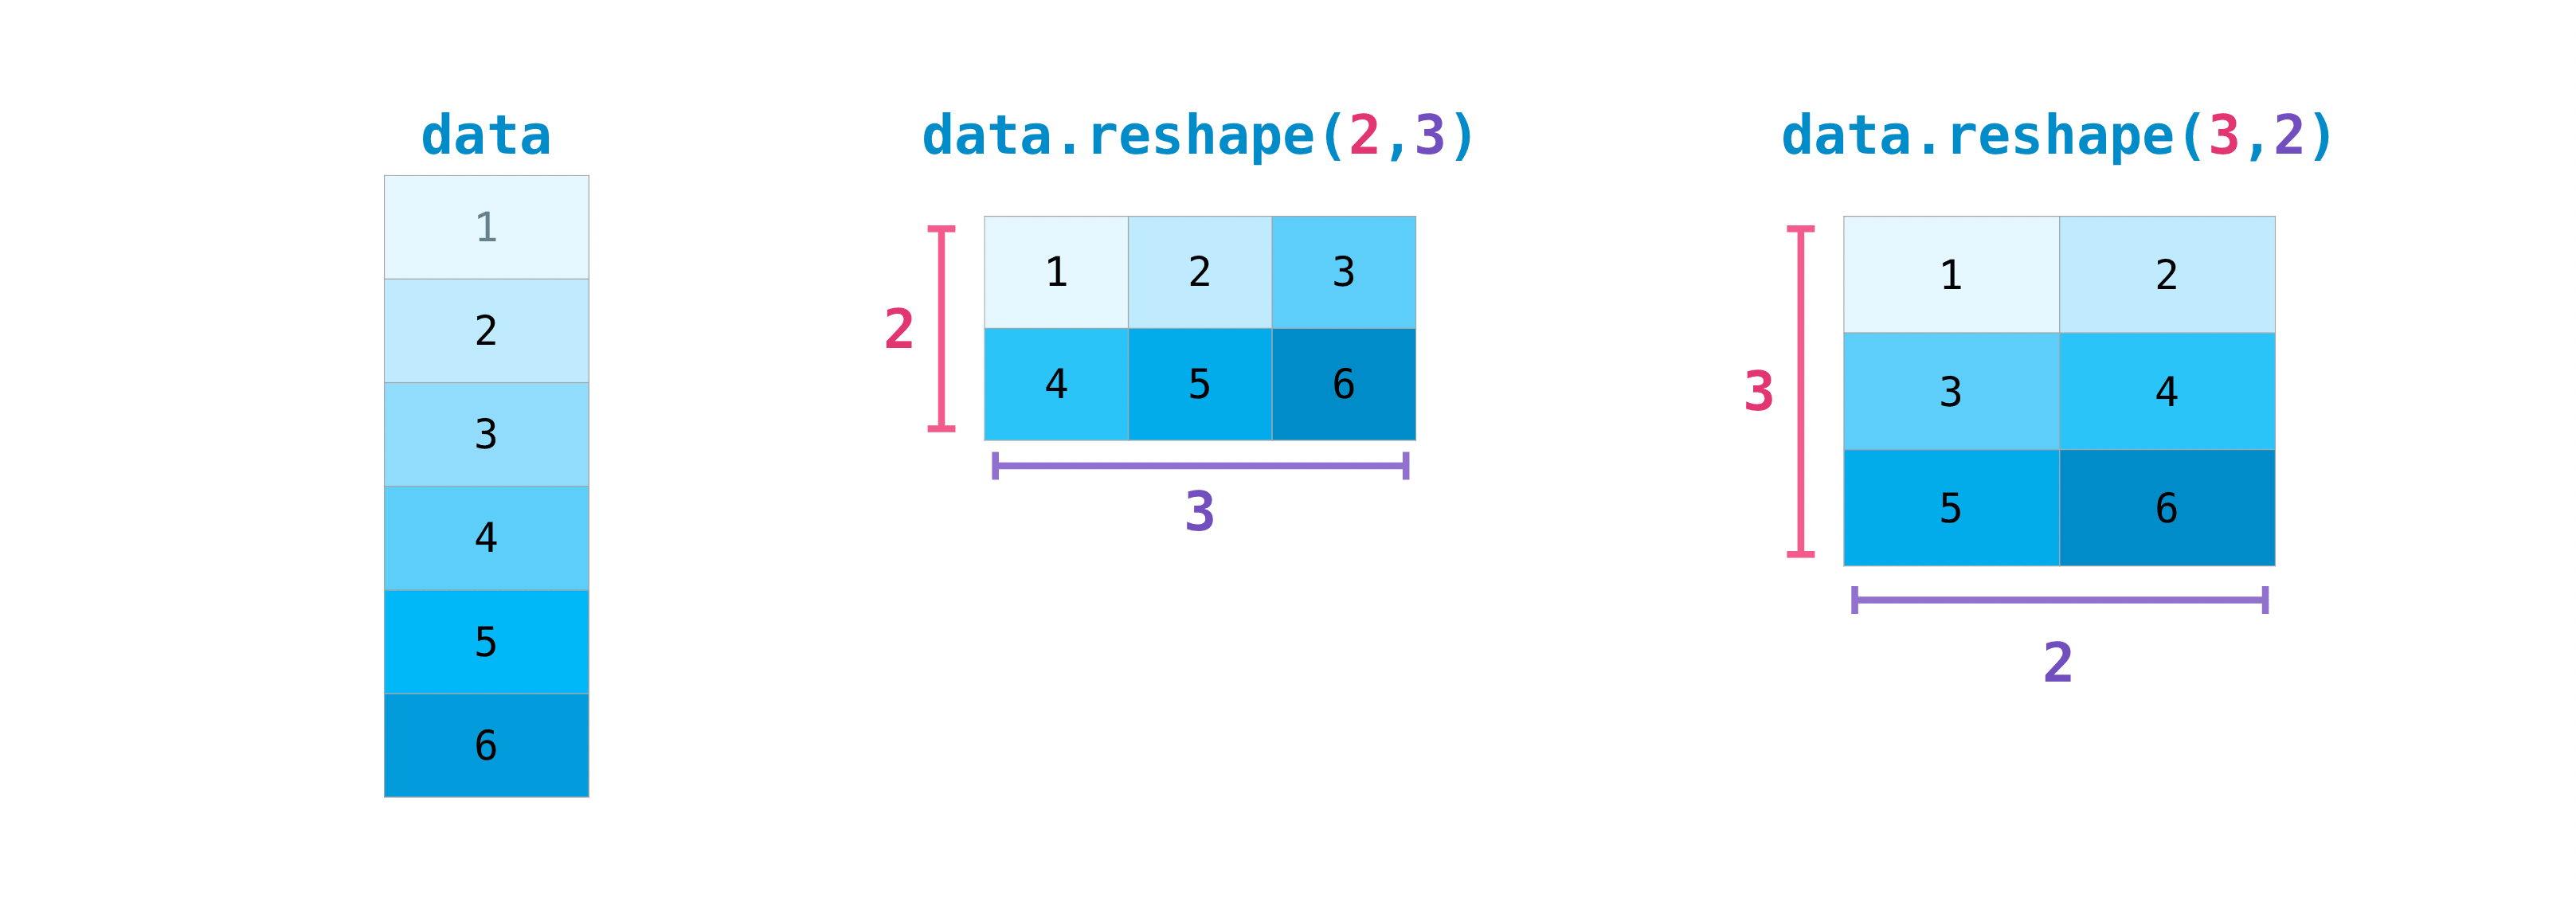
Abb.: Formänderung (Reshaping)
a = np.arange(3, 0, -0.25)  # 1D-Array mit 12 Elementen
print(a)
b = a.reshape((3,4))  # 2D-Array mit 3 Zeilen und 4 Spalten (= 12 Elemente)
print(b)
[3. 2.75 2.5 2.25 2. 1.75 1.5 1.25 1. 0.75 0.5 0.25]
[[3. 2.75 2.5 2.25]
[2. 1.75 1.5 1.25]
[1. 0.75 0.5 0.25]]
3.2 Indizierung und Slicing
Wie bei Listen erfolgt das Indizieren/Slicing mit [].
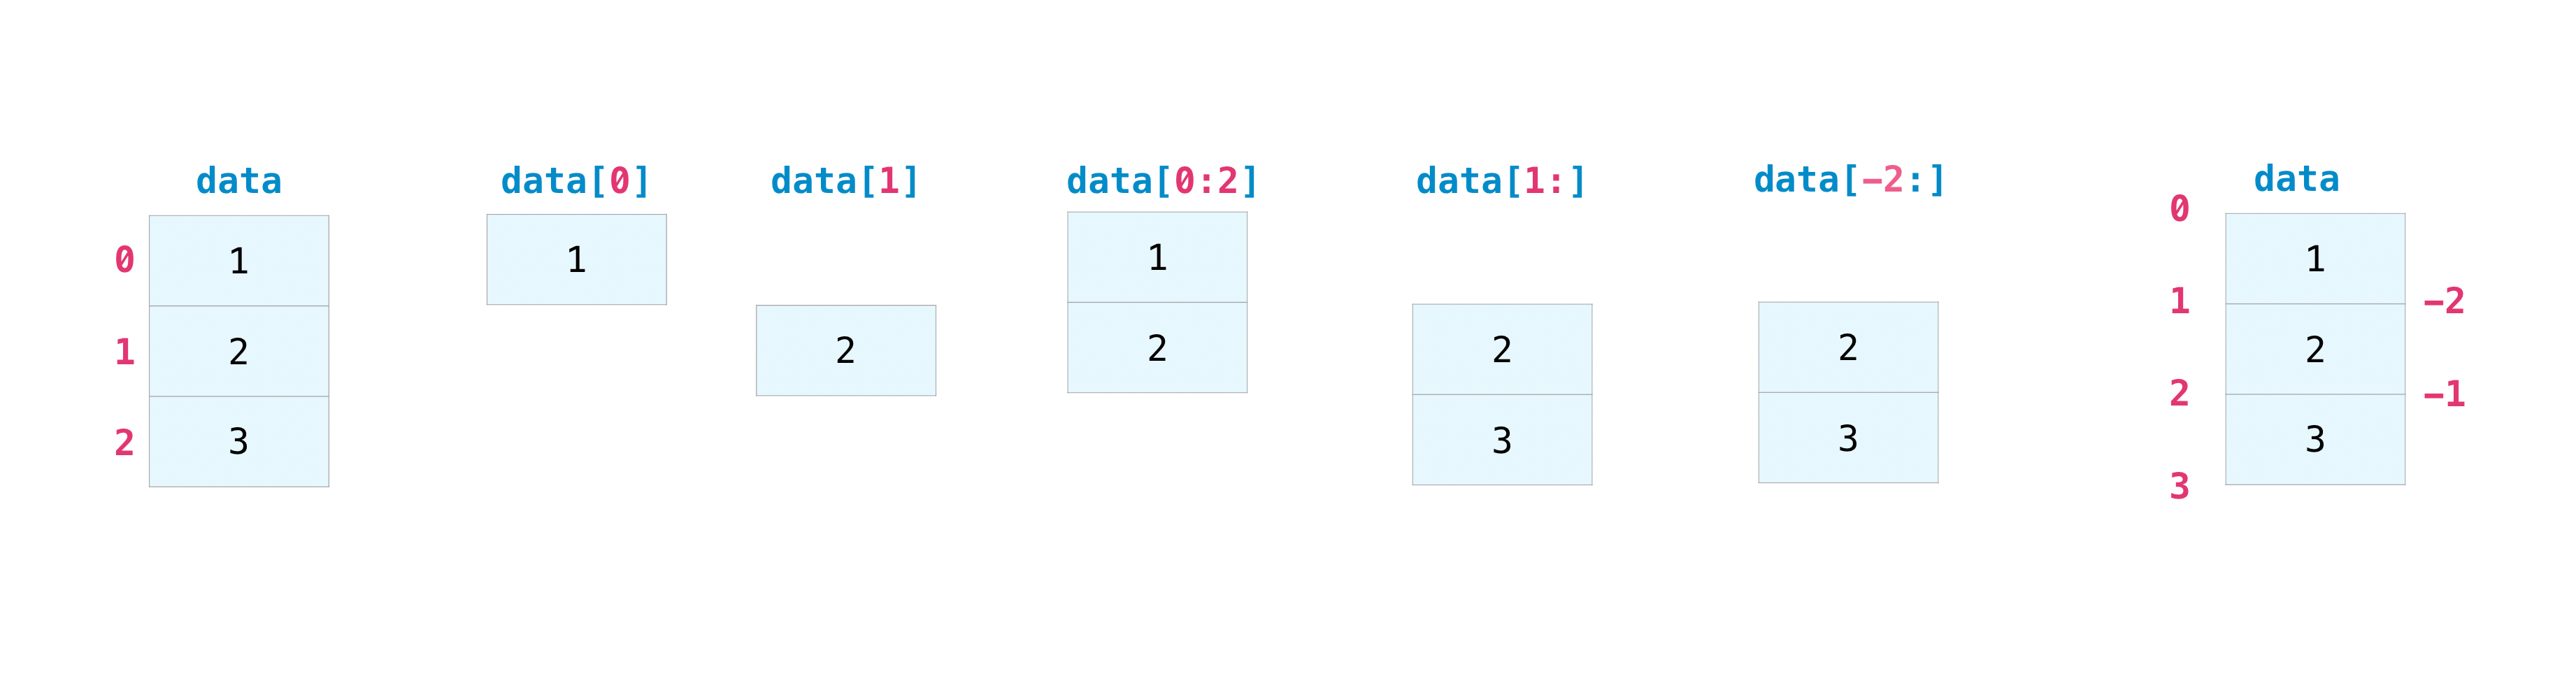
Abb.: Indizierung und Slicing (1D)
# 1D-Array
print(a[0])  # erstes Element (Index 0)
print(a[-1])  # letztes Element
print(a[4:9])  # Slicing
3.0
0.25
[2. 1.75 1.5 1.25 1. ]
Für höherdimensionale Arrays ist die Indizierung bedeutend intuitiver als bei Listen, da nicht mehrere Klammern verwendet werden müssen, sondern die Indizes mit , getrennt werden können.
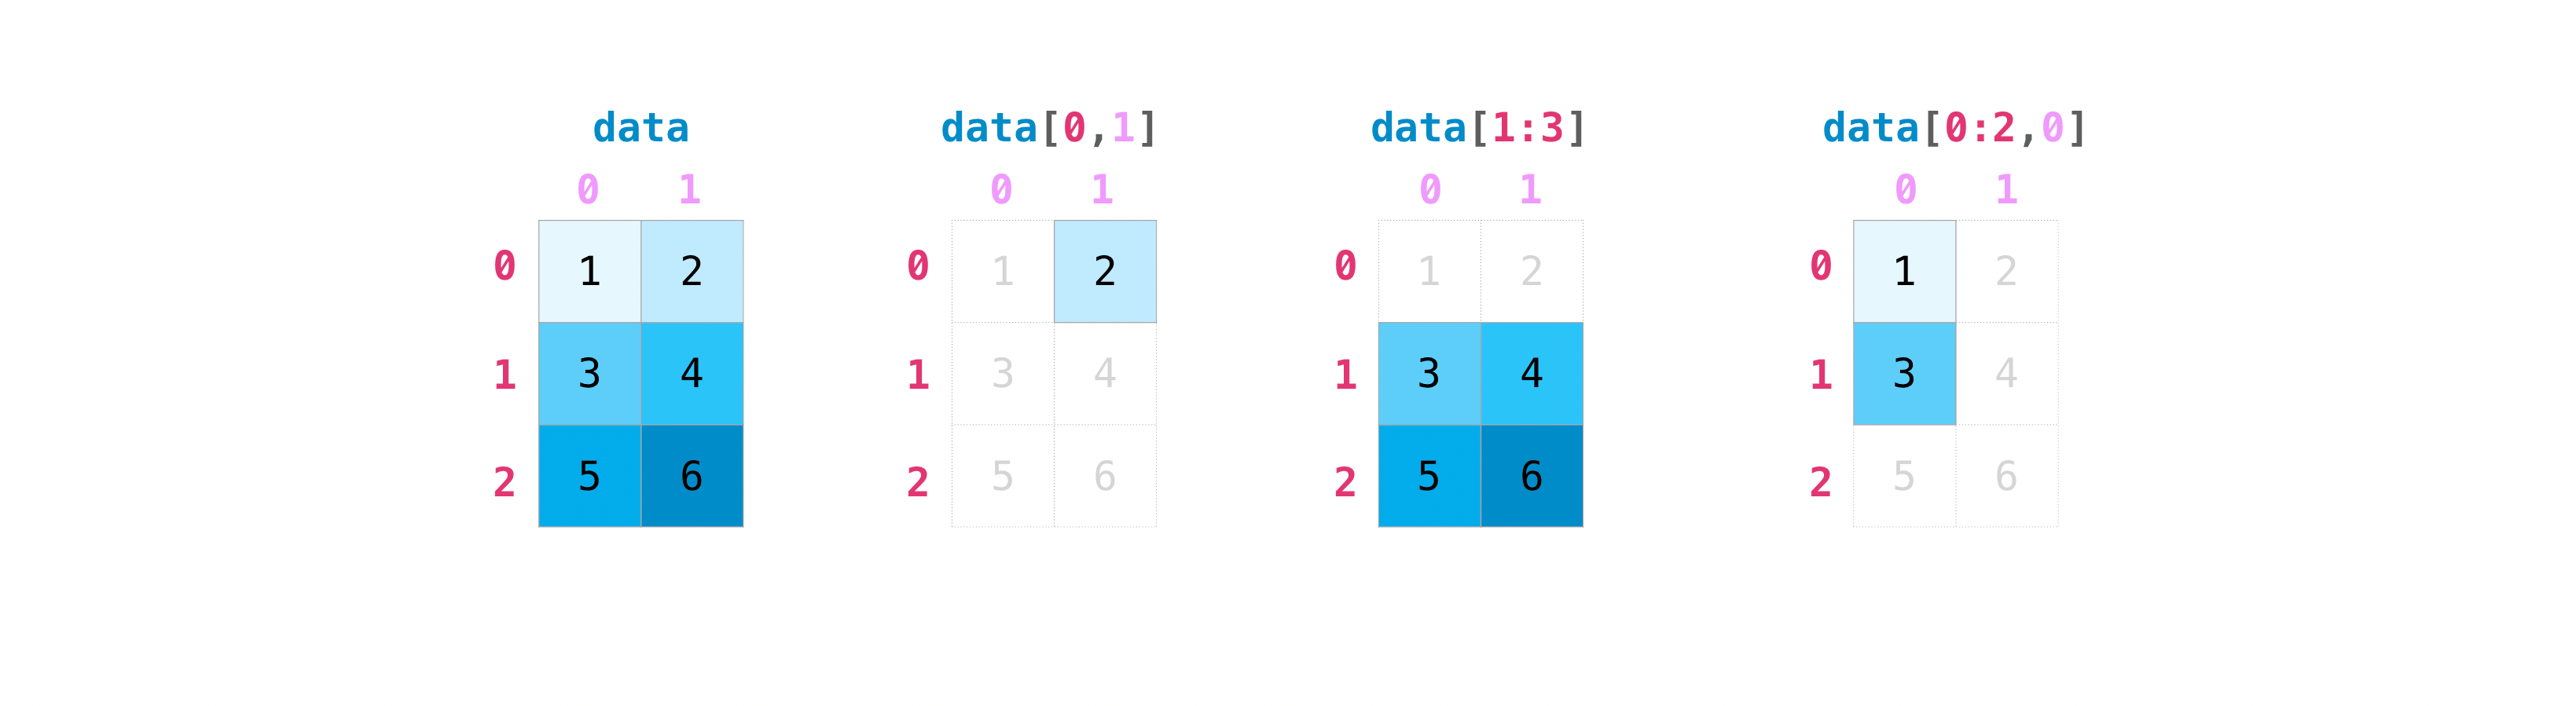
Abb.: Indizierung und Slicing (2D)
# 2D-Array
print(b[0,0])  # Element in erster Zeile / erster Spalte
print(b[1,:])  # alle Elemente der zweiten Zeile (alternativ b[1])
print(b[:,2])  # alle Elemente der dritten Spalte
3.0
[2. 1.75 1.5 1.25]
[2.5 1.5 0.5]
Besonders erwähnenswert im Zusammenhang mit der Indizierung ist die boolesche Indizierung (boolean indexing), die sehr praktisch ist, um einen Array anhand seiner Elemente (Werte) zu “filtern”, d. h. nur bestimmte Elemente zu identifizieren.
print(a[a>2])  # alle Elemente aus a, die grösser als 2 sind
print(a[(a>1)&(a<2)])  # alle Elemente aus a, die grösser als 1 und kleiner als 2 sind
a[(a>=2.5)|(a<=0.5)] = 0  # alle Elemente aus a, die grösser/gleich 2.5 oder kleiner/gleich 0.5 sind auf 0 setzen
print(a)
[3. 2.75 2.5 2.25]
[1.75 1.5 1.25]
[0. 0. 0. 2.25 2. 1.75 1.5 1.25 1. 0.75 0. 0. ]
Dies wird boolesche Indizierung genannt, weil in den []-Klammern dabei ein boolescher Array steht, der für jedes Element entweder True oder False ist.
print(a>1) # Vergleiche führen zu booleschem Array[False False False True True True True True False False False False]
print(a[a>1]) # Indizierung mit booleschem Array (siehe auch Bsp. oben)[2.25 2. 1.75 1.5 1.25]
3.3 Editieren/Kopieren
Elemente in Arrays können verändert werden, wie wir dies von Listen kennen. Wie bei Listen muss beachtet werden, dass eine Zuweisung eines Arrays a zur Variable b, also b = a, keine Kopie aller Arrayelemente vornimmt, sondern lediglich die Referenz auf den Array kopiert. Der Array b “enthält” dann dieselben Elemente wie a und wenn ein Element in b verändert wird, so zeigt sich diese Änderung auch in a.
a = np.array([1, 2, 3])
b = a  # keine Kopie, nur Zuweisung (Referenz)
b[1] = -99  # auch a wird verändert
print('a: ', a)
print('b: ', b)
a: [ 1 -99 3]
b: [ 1 -99 3]
Eine wirkliche (eigenständige) Kopie kann mit der Methode .copy() erzeugt werden.
a = np.array([1, 2, 3])
b = a.copy()  # Kopie
b[1] = -99  # a ist nicht betroffen
print('a: ', a)
print('b: ', b)
a: [1 2 3]
b: [ 1 -99 3]
4. Numerische Berechnungen
NumPy bringt ebenfalls alle relevanten Konstanten und mathematischen Funktionen mit sich, die man für technische/mathematische Berechnungen benötigt. Der Import des math-Moduls ist somit nicht nötig, wenn mit NumPy gearbeitet wird.
4.1 Konstanten
Nützliche Konstanten:
np.pi- Kreiszahlnp.e- Eulersche Zahlnp.inf- unendlich, z. B. bei Division durch 0np.nan- undefiniert, not a number
4.2 Funktionen
Eine Auswahl von nützlichen mathematischen Funktionen, die (hoffentlich :-) selbsterklärend sind:
np.sqrt()- Wurzelfunktionnp.square()- Quadrat-Funktionnp.sin(),np.cos(),np.tan()- Winkelfunktionennp.arcsin(),np.arccos(),np.arctan()bzw.np.arctan2()- inverse Winkelfunktionennp.exp()- Exponentialfunktionnp.log(),np.log10()- Logarithmusfunktionen
Nützliche Umrechnungsfunktionen bzw. Hilfsfunktionen:
np.absolute()- Absolutwert (Betrag)np.sign()- Vorzeichennp.degrees()bzw.np.rad2deg()- Umrechnung Radiant nach Gradnp.radians()bzw.np.deg2rad()- Umrechnung Grad nach Radiantnp.angle()- Winkel (Phase) einer komplexen Zahlnp.real(),np.imag()- Real- bzw. Imaginärteil einer komplexen Zahl
Funktionen zum Runden:
np.round()- allg. Funktion zum Rundennp.floor()- Abrunden auf nächstkleinere ganze Zahlnp.ceil()- Aufrunden auf nächstgrössere ganze Zahl
Ein grosser Vorteil von NumPy liegt in der Einfachheit, mit der mathematische Berechnungen mit Arrays durchgeführt werden können. Am Beispiel der folgenden Formel zur Berechnung des quadratischen Mittelwertes (Effektivwert) (root mean square) von Zahlen wollen wir dies illustrieren.
☝🏼 Würde man mit einer Liste arbeiten, könnte die Berechnung nicht so direkt umgesetzt werden und es wäre eine Schleife oder z. B. die map-Funktion nötig.
N = 100
x = np.random.standard_normal(N)  # 100 standardnormalverteilte Zufallszahlen

RMS = np.sqrt(1/N * np.sum(np.square(x)))  # Die obige Formel mit NumPy
print(RMS)
1.005669233438984
💡 Verständnisfragen
Welche Unterschiede bzw. Gemeinsamkeiten zwischen Arrays und Listen gibt es?
Was ist der Unterschied zwischen einem 1D- und einem 2D-Array?
Wie ermittelst du die Anzahl Zeilen (und/oder Spalten) eines 2D-Arrays?
Wie berechnest du den Mittelwert aller Elemente eines Arrays?
Wie erzeugst du einen 1D-Array, der äquidistante Werte zwischen 10 und 20 enthält, mit einem Abstand von jeweils 0.75?
Wie erzeugst du einen mit Nullen gefüllten 2D-Array mit 4 Zeilen und 6 Spalten?
Wie würdest du mit NumPy die Beziehung schreiben, wenn ein Array ist mit 1000 Elementen und für jeden Wert von berechnet werden soll, d. h. auch 1000 Elemente aufweisen soll?
A. Anhang
Hier folgen weiterführende Informationen zum NumPy-Array, die wir allerdings im Unterricht nicht benötigen und daher als optional zu betrachten sind.
A.1 Elementdatentyp
Da NumPy für maximale Performance entwickelt wurde, unterscheidet sich der Array dahingehend von der Liste, dass sämtliche Elemente im Array denselben Datentyp aufweisen. Dieser Elementdatentyp kann optional bei der Erstellung zugewiesen werden und es steht eine Reihe von spezifischen Datentypen zur Verfügung, wobei die Zahl jeweils für die entsprechende Bitgrösse steht:
np.uint8/16/32/64- vorzeichenlose Ganzzahlen (unsigned integer)np.int8/16/32/64- vorzeichenbehaftete Ganzzahlen (signed integer)np.float16/32/64/96/128- Gleitkommazahlen (floating point)np.complex64/128/192/256- komplexe Zahlen (complex)
Dies ermöglicht es, für eine bestimmte Anwendung den optimalen (in Bezug auf den Speicherplatz kleinstmöglichen) Datentyp zu wählen.
☝🏼 Der Elementdatentyp uint16 beinhaltet z. B. nur vorzeichenlose (u steht für unsigned) Ganzzahlen (also nur positive, ganze Zahlen) und weist 216 verschiedene Zahlen auf. Da die 0 eingeschlossen ist, ist der Wertebereich auf also beschränkt. Der Elementdatentyp int16 dagegen beinhaltet auch negative Ganzzahlen und enthält ebenfalls 216 verschiedene Zahlen. Der Wertebereich beträgt dann also .
a = np.array([[-1, 0, 1, 2],
              [0, 1, 3, 1]], dtype=np.float32)  # explizite Datentyp-Zuweisung
print(a, a.dtype)
[[-1. 0. 1. 2.]
[ 0. 1. 3. 1.]] float32
Der Datentyp kann mit der Methode .astype() geändert werden.
b = a.astype(np.int8)  # Datentyp-Umwandlung
print(b, b.dtype)
[[-1 0 1 2]
[ 0 1 3 1]] int8
Wird der Datentyp nicht explizit angegeben, wählt NumPy automatisch einen passenden Datentyp. Wir werden in der Regel so arbeiten und uns daher i. Allg. nicht mit dem Elementdatentyp beschäftigen.
a = np.array([-1, 0, 1, 2])  # automatische Datentyp-Zuweisung (Ganzzahl)
print(a, a.dtype)
a = np.array([0.1, 1, 10])  # automatische Datentyp-Zuweisung (Gleitkommazahl)
print(a, a.dtype)
[-1 0 1 2] int64
[ 0.1 1. 10. ] float64